随着生成式AI进一步嵌入到各行各业,越来越多的企业也注意到了微调(fine-tuning)这种模型训练方式。尤其对于已积累大量历史译文、术语等语料数据的企业来说,通过微调训练获得专属模型的想法格外具有吸引力。然而,在企业翻译的业务领域中想要持续提升输出质量并降低生产成本,微调这种训练模式是否真的是理想的解决方案呢?
什么是微调?
微调是指在预训练通用大模型的基础上,使用某一领域或任务的训练数据进一步调整模型参数,使其更适应特定的应用场景。
翻译业务中的微调,是指用具体语料样本如翻译记忆库(TM)、术语库(TB)、风格指南等对模型做进一步训练,从而得到一个独立的定制模型版本,以便更好地适配特定的术语习惯、语言风格与表达方式,并满足特定翻译任务的要求。
微调并非翻译业务的终局
通用大模型在垂直领域和内容场景下往往表现欠佳,其根源就是缺乏该领域的专业数据和知识积累。既然拥有语料数据就可以进行微调训练,那么这是否意味着微调之后的模型就可以一劳永逸地解决翻译问题了?答案是否定的,主要有以下三个原因:
微调的质量取决于数据质量:拥有翻译语料数据的企业很多,但是真正拥有高质量数据的企业却极少。试想如果历史语料中的术语和表达不一致、翻译风格混乱,甚至包含各种低级错误,那么使用这些数据训练出来的结果可想而知,微调本身也就失去了意义。
微调的成本被严重低估:想要实现微调训练,首先是对语料进行清洗优化、筛选对齐与质量控制的人力投入;其次是训练过程中的算力资源,以及模型的软硬件配置与消耗;还有训练中和完成后进行测试验证、跟踪监控和语料管理闭环的长期维护。
微调的效果受时效影响极大:微调与特定的基础模型和语料数据深度绑定,而目前大模型的迭代速度越来越快,有可能微调完成时,其使用的基础模型版本已经过时。此外,绝大多数企业的语料数据也在快速更新:技术术语、核心表达,甚至是写作风格都会频繁发生变化,导致微调后的模型能力无法跟上动态的需求变化。
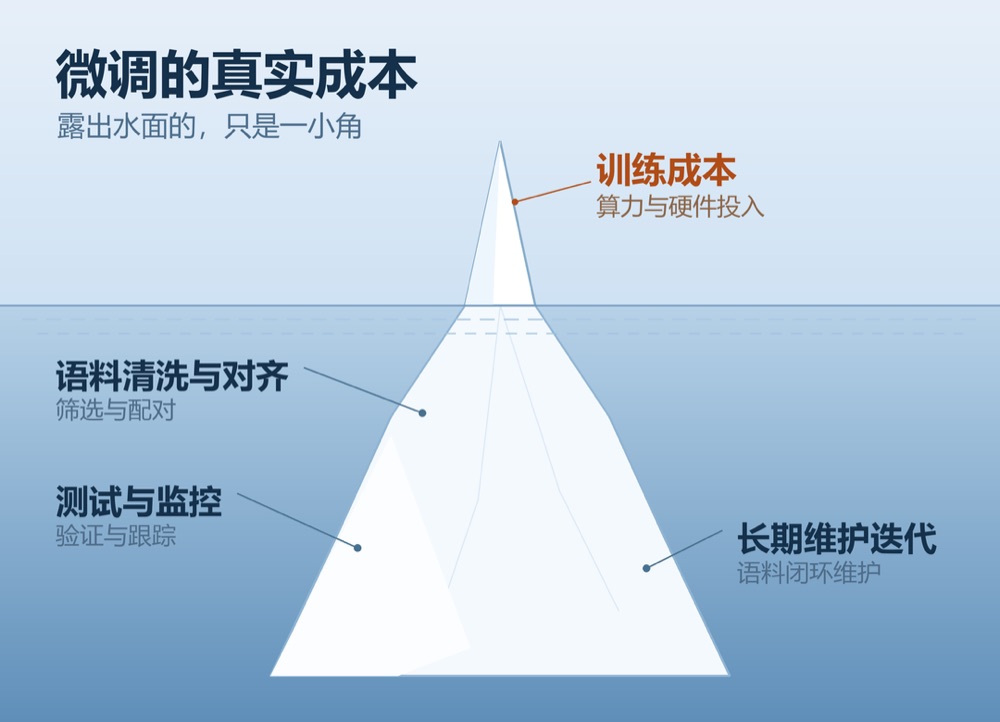
图1:一次微调里,训练只是露出水面的那一角
知识管理不可或缺
企业开展模型微调,不但要投入基本的AI软硬件成本,更需要语言专家的持续维护;而微调这种依靠训练重塑模型能力的实现方式,在现实中很难跟上企业语言业务快速变化的步伐,因此存在资源错配与浪费的风险。
但另一方面,微调所依赖的语料数据标准化管理,对所有企业而言都是必不可少的。专业化的知识管理可以让企业拥有一套高质量的语料数据库,这些独立动态管理的语料数据可以与提示词和模型一起形成模块化且高度灵活的AI翻译架构。这样一来,无论是句段、术语还是写作风格的偏好发生变化,都可以在下一次翻译任务中直接体现出来,无需再重新进行繁琐的模型微调。
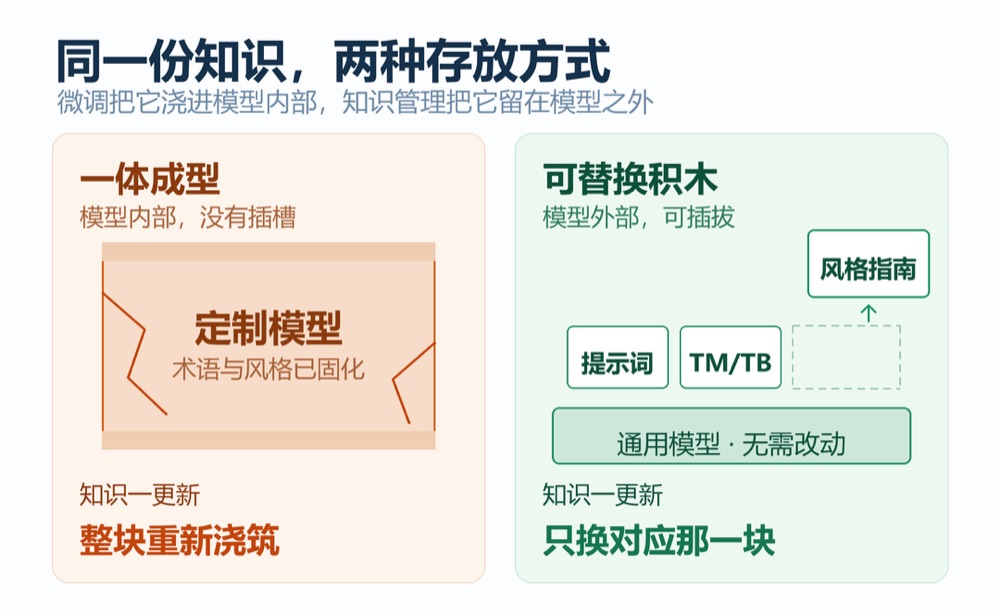
图2:同一份知识——浇进模型是一体化的成品,留在模型外是可组装的积木
结语
提升AI翻译质量与效率,不仅依赖模型能力,更取决于语言知识的积累、管理与应用。然而,高质量的知识管理需要语言专家和技术能力的持续投入,大多数企业很难独立承担组建和维护专职知识管理团队的成本。
因此,与具备丰富语言知识管理经验的专业语言服务供应商建立稳定的合作关系,往往是更为实际可行的选择。通过语言服务供应商在语料管理、提示词工程和质量控制方面的专业能力,企业能够充分利用现有语言资产,持续提升翻译质量与效率,而不必急于投入模型微调,就可以通过语言知识持续创造价值。